13.9 亿 Token 只花 197 块:8 月 AI 用量双口径复盘
核心结论
把”花了多少钱”和”用了多少算力”两份报表叠在一起,2026 年 8 月的数据是:
| 口径 | 数值 |
|---|---|
| 真实支出(平台账单折算) | ¥196.66(3,286 次请求) |
| 牌价等值(本地 Token × 公开价) | ¥813.16(1,390,620,186 Tokens) |
| 隐性补贴 | ¥616.50(75.8%) |
| 缓存重读占比 | 93.46%(无折扣月费将为 ¥8,460.04) |
| Top 20 / 204 会话的 Token 占比 | 81.2% |
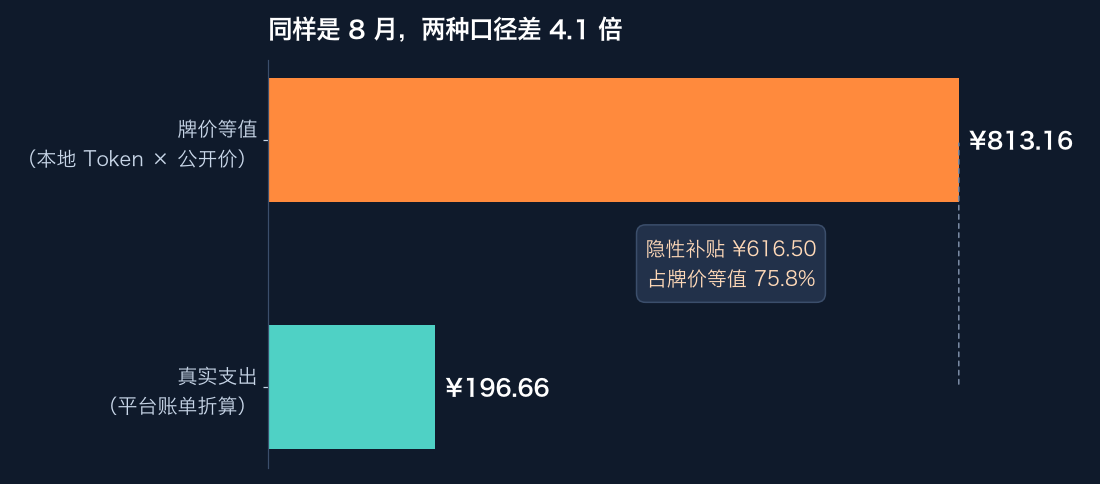
隐性补贴 = ¥616.50 / 月,占牌价等值的 75.8%。 这笔钱由各平台送的免费 Token / -free 免费模型 + 轮流订阅的额度替我出了——8 月 Token 报表里那 30.2% 的 -free 模型用量,账单上记的是 ¥0,但在 Token 报表里被按同款付费模型的牌价估值了 ¥160.86,这样才能看清”我到底消耗了多少算力”。这笔补贴不会出现在任何账单里,直到有一天平台收紧免费额度——到那一天我的真实支出会从 ¥197 直接跳到 ¥800+ 量级。
三个结论:双口径必须同时看;缓存折扣扛掉了 90.4% 的上下文搬运成本;成本优化该抓异常值,不是改习惯。
一、为什么需要两个口径
我的用法是”轮流薅”:订阅制 IDE 每月换一家(8 月 CodeBuddy,5 个账号轮流耗额度),DeepSeek 开放平台为按量 API,用量大头靠平台赠送的免费 Token 与 -free 模型(54.2% 请求、30.2% Token 走免费额度)。
三种数据源各有盲区:
| 数据源 | 它告诉你 | 它不告诉你 |
|---|---|---|
| 各平台后台 / 导出 | 请求次数、积分、扣费(真实支出) | Token 体量、单次请求重量 |
| 本地会话日志 | Token 数、缓存命中、模型名 | 实际扣费 |
| 厂商配额页 | 配额余量 | 真实消耗 |
两个开源 Skill 各覆盖一侧:ai-usage-report 抓平台账单(CodeBuddy / Qoder / TRAE / DeepSeek),ai-token-usage 读本地日志(Claude Code / OpenCode / Copilot)。登录态就绪后月度全流程约 10 分钟。
关键认知:两者覆盖的客户端几乎不重叠——账单侧 91% 的请求在 CodeBuddy,Token 侧 91% 的量在 Claude Code + OpenCode。所以所有数字分列呈现,不做加法。
二、账单侧:¥196.66 的结构
| 平台 | 请求次数 | 占比 | 折算费用 | 占比 | 单次均价 |
|---|---|---|---|---|---|
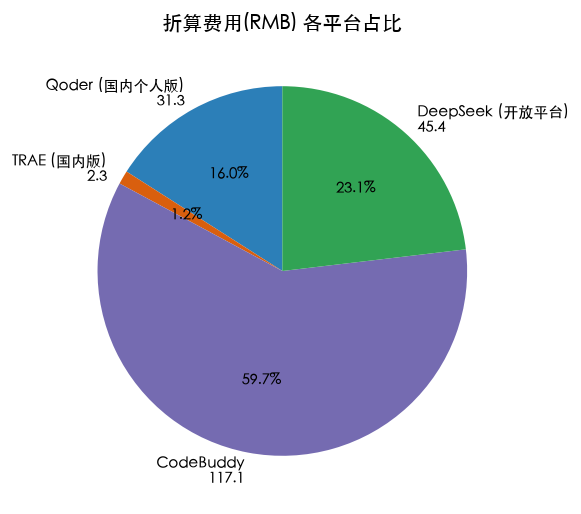
| CodeBuddy(5 账号) | 3,002 | 91.4% | ¥117.57 | 59.8% | ¥0.039 |
| DeepSeek(开放平台) | 108 | 3.3% | ¥45.37 | 23.1% | ¥0.420 |
| Qoder(2 账号) | 64 | 1.9% | ¥31.30 | 15.9% | ¥0.489 |
| TRAE(2 账号) | 112 | 3.4% | ¥2.42 | 1.2% | ¥0.022 |
| 合计 | 3,286 | 100% | ¥196.66 | 100% | ¥0.060 |
不对称点:CodeBuddy 用 91.4% 的请求只占 59.8% 的费用;DeepSeek 用 3.3% 的请求占 23.1% 的费用。免费 / 付费请求 = 1,781 / 1,505;请求量 Top 模型 hy3 1,628 次全部走免费额度,deepseek-v4-flash 611 次、deepseek-v4-pro 470 次。
钱花在哪、次数花在哪,是两个不同的分布:
| 折算费用(RMB)占比 | 请求次数占比 |
|---|---|
 |
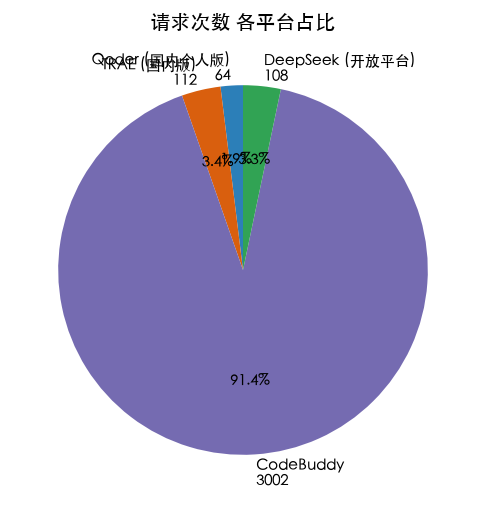 |
只看其中一张饼图,你会得出完全相反的结论。
每日费用曲线——注意账号之间的接力:8/1–8/12 费用几乎全在主账号 kyxxxxab,8/13 起重心转移到 135-08 → 138-32 → 139-32 → 136-91,这正是”轮流把各账号额度用满”的直接证据:
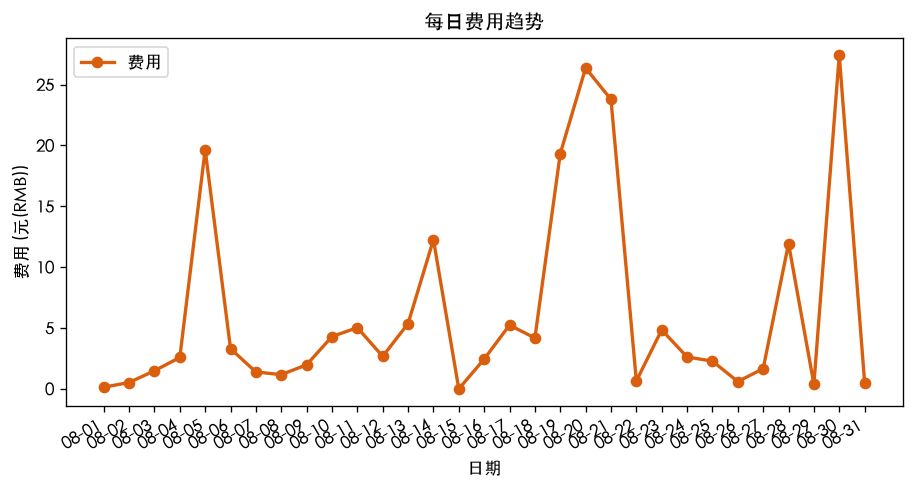
费用峰值日:CodeBuddy 8/20(¥26.37)、8/21(¥23.60);DeepSeek 8/30(¥24.54)。请求量 Top 模型:hy3 1,628 次(全部走免费额度)、deepseek-v4-flash 611 次、deepseek-v4-pro 470 次。
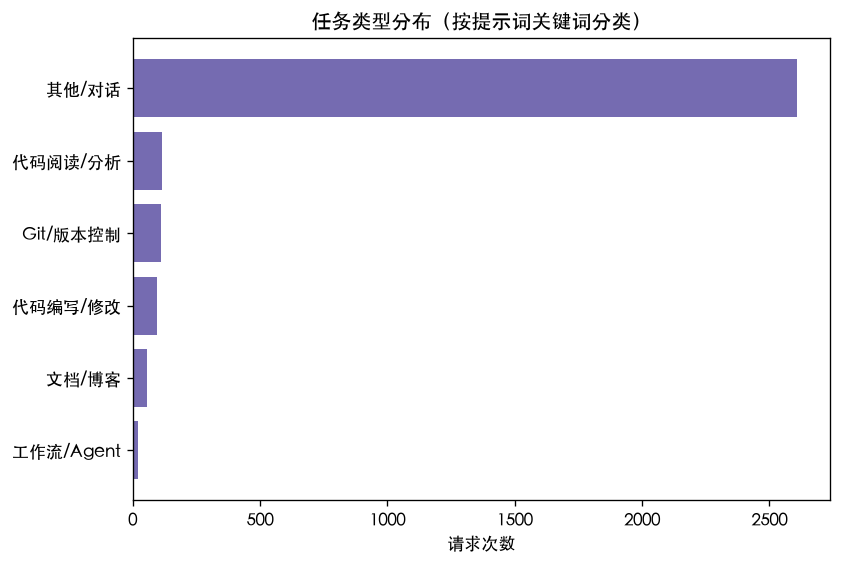
下面这张图是这套图表里唯一不该被当真的一张——任务类型分布里 86.9% 落在”其他/对话”,这是关键词分类规则覆盖率不足(平台不回传 prompt 全文),不是真实分布。它恰好证明了”为什么不能只信一张图”:
订阅制的成本随次数线性增长且边际趋近于零;按量 API 的成本随上下文体量增长。 用请求次数衡量成本会误导,用 Token 衡量又会忽略订阅的边际成本——两个指标必须同时看。
三、Token 侧:93.46% 的验算
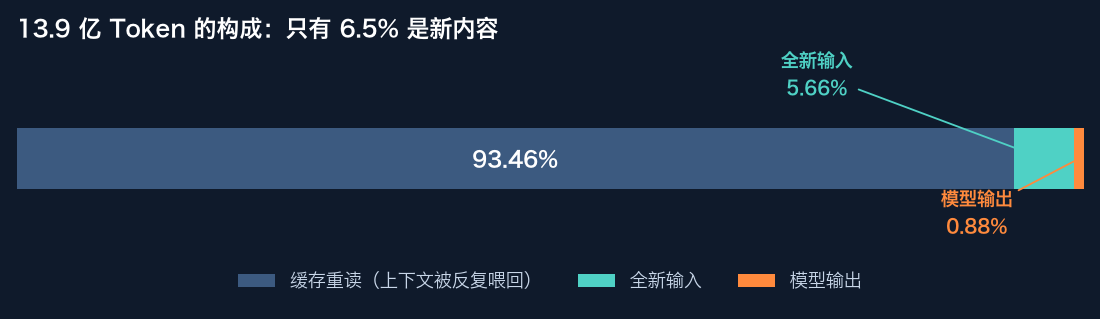
总 Token 1,390,620,186,其中缓存重读 1,299,678,784(93.46%)、全新输入 78,693,336(5.66%)、输出 12,248,066(0.88%);输入 : 输出 = 112.5 : 1;204 会话 / 14,700 轮 / 22 活跃天。
按模型拆分:
| 模型 | Tokens | 占比 | 等值费用 | 计费性质 |
|---|---|---|---|---|
| deepseek-v4-pro | 806,913,101 | 58.0% | ¥599.94 | 付费 |
| hy3-free | 299,921,169 | 21.6% | ¥115.39 | 免费额度 |
| deepseek-v4-flash | 163,551,983 | 11.8% | ¥50.74 | 付费 |
| deepseek-v4-flash-free | 80,556,926 | 5.8% | ¥37.37 | 免费额度 |
| mimo-v2.5-free | 38,773,758 | 2.8% | ¥8.10 | 免费额度 |
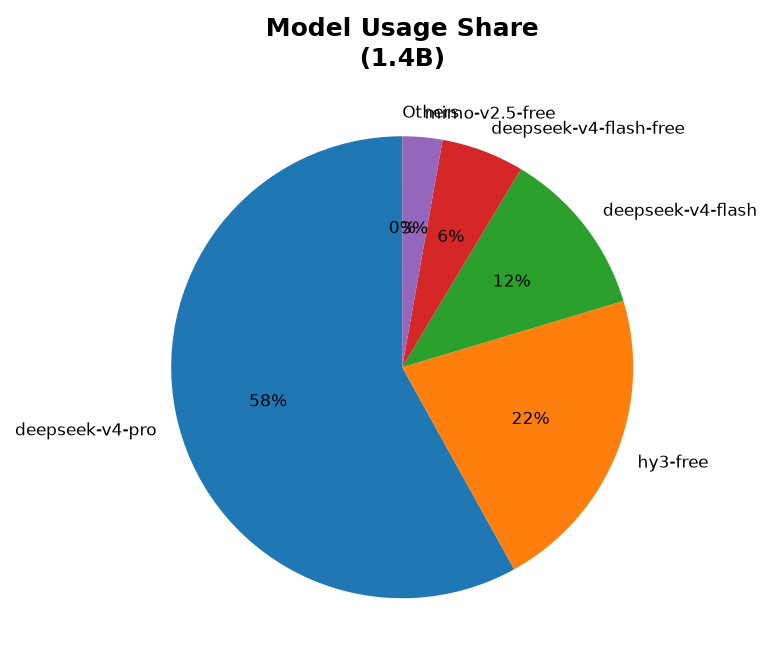
注意:上面饼图里的费用是”牌价等值”——*-free 模型被按同款付费模型的牌价估值(这是刻意的,否则免费用量会隐形),但它们在账单上的真实金额是 ¥0。
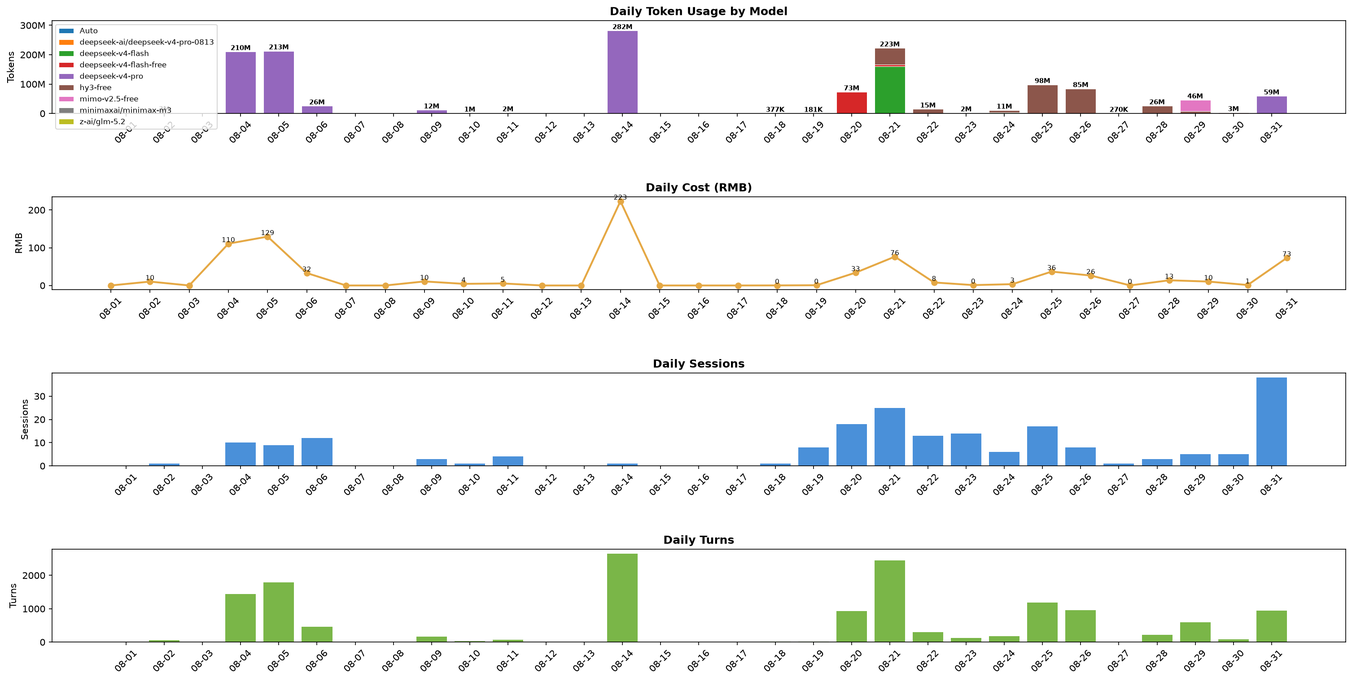
算法: 报表的 input_tokens 已折叠缓存重读(缓存另单独记 cache_read_tokens),故 缓存占比 = cache_read_tokens / total_tokens。
三路验算:
- 加总守恒:9 个模型 cache 逐项求和与总量一致;
- 费用反推:按模型独立重算得 $120.70 × FX 6.737 = ¥813.16,与报表吻合;
- 原始日志抽样:
cache_read_input_tokens为厂商原生上报字段。
缓存牌价(USD / 1M tokens):
| 模型 | input | cache_read | output | cache ÷ input | cache ÷ output |
|---|---|---|---|---|---|
| deepseek-v4-pro | $1.32 | $0.044 | $3.96 | 1/30 | 1/90 |
| deepseek-v4-flash | $0.44 | $0.014 | $1.32 | 1/31 | 1/94 |
| hy3 | $0.148 | $0.037 | $0.594 | 1/4 | 1/16 |
反事实: 缓存按普通输入价计费,月费为 ¥8,460.04,缓存折扣省下 ¥7,646.88(90.4%)。换平台、清空会话、逐轮全量重喂大文件,等价于放弃这层折扣——同一份工作成本放大 10 倍。
四、会话集中度
| 切片 | 占全月 Token |
|---|---|
| Top 1 | 20.3%(281.7M,2,646 轮,8/14,等价 ¥223.34) |
| Top 3 | 43.0% |
| Top 10 | 66.5% |
| Top 20 | 81.2% |
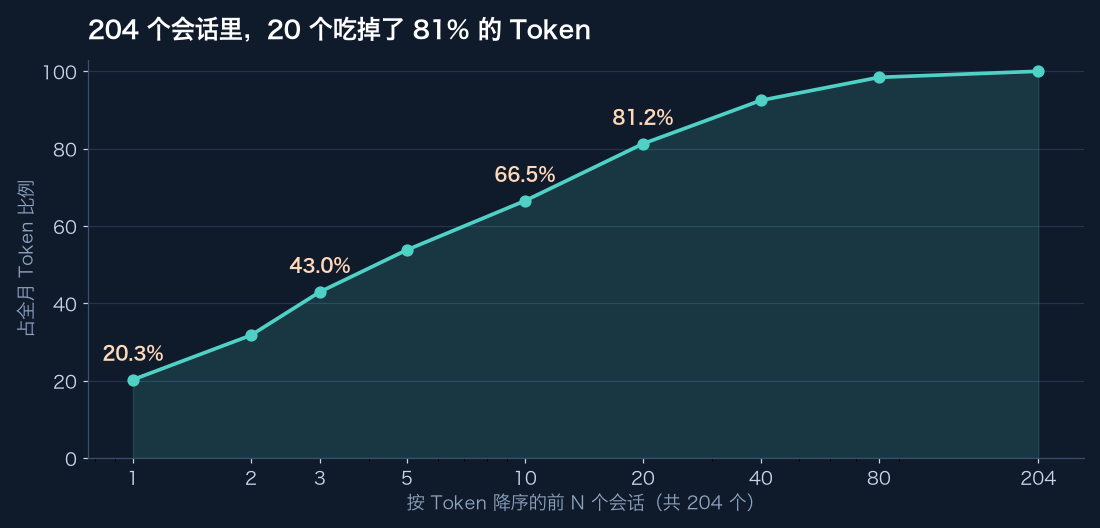
中位数 326,570 vs 均值 6,816,765(20.9×),极度右偏。“平均使用强度”是无效优化目标——审 3~10 个巨型会话的存在必要性,即可影响 43%~66% 的总量。Top 1 会话单月超过整月真实账单。
五、三条决策规则
- 双口径同时看,分列呈现,不做加法。
- 按任务分层路由:高频短请求 → 订阅制 IDE(¥0.022~0.039/次);特定模型 / 长上下文深度任务 → 按量 API(¥0.420/次);批量 Agent 循环 →
-free模型(已承接 30.2% Token)。 - 盯缓存率而非 Token 总量:大文件按需引用;单会话超 100M Token 主动开新窗口;每月记录 cache_read / total,低于 90% 检查上下文结构。
数据口径备注
- Token 侧日级求和与月度总量差 698,695,跨月对比以月度 / Session 级为准;
- 任务类型关键词分类覆盖率不足(CodeBuddy 86.9% 归入”其他/对话”),不可用于归因;
- 3 个模型按 fallback / 子串匹配牌价估算,合计 ¥1.39;
- 临时账号缺日属正常(少用即零用量),与主账号活跃窗口一致。
复现清单
- 安装
ai-usage-report/ai-token-usage,各自跑一次init.py; - 各平台导出当月账单至
data/<platform>/raw/,运行normalize.py; - 无导出的平台跑
scrape_usage.py --start <月首> --end <月末>; generate_reports.py生成 per-vendor + summary;- Token 侧跑
ai_token_usage.py --since <月首> --until <月末>; - 跨机器用
--import-data合并 store; - 归档至
summary/<日期>/,每月 1 号例行,做环比。
本篇是系列「AI 高性价比使用策略」的实测篇,方法论见上一篇《算清你的 AI 用量与成本》。
本文的度量方法由两个开源 Skill 实现,源码地址:
- Gitee:https://gitee.com/KylinLab/kylinlab.tech.skills
- GitHub:https://github.com/KylinLabAI/kylinlab.tech.skills